Sprachmodelle können Handlungen erklären, aber keine Roboter steuern. Weltmodelle sollen Zustandsänderungen der physischen Umgebung berechnen und dadurch Wahrnehmung, Planung und Aktion verbinden. Entscheidend sind dabei nicht nur Modellarchitekturen, sondern kompatible Trainingsdaten aus unterschiedlichen Maschinen.
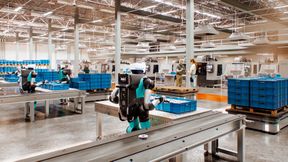
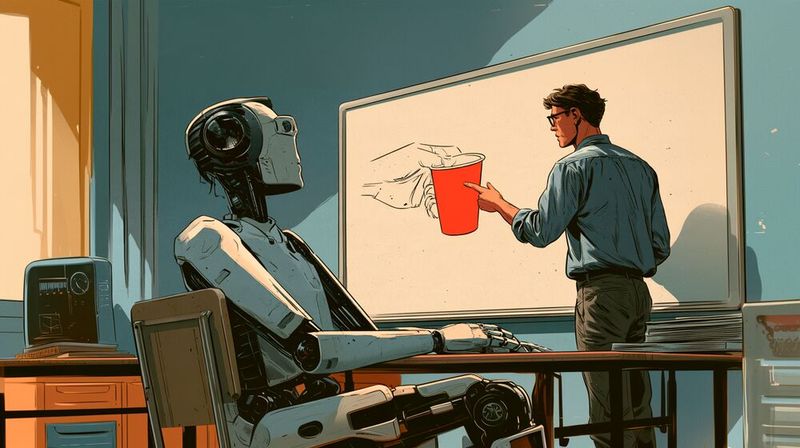
Ein Weltmodell soll dem Roboter nicht nur erklären, wie er einen Becher greift, sondern auch die Folgen seiner Bewegung berechnen.
(Bild: Midjourney / KI-generiert)
Künstliche Intelligenz (KI) ist mittlerweile in der Lage, Software zu schreiben, Verträge zu analysieren und komplexe Szenen mit bemerkenswerter Genauigkeit zu beschreiben. Fragt man sie, wie man einen roten Becher von der Küchentheke nimmt und ihn in ein Regal stellt, liefert sie eine absolut schlüssige Abfolge von Schritten.
Es gibt dabei aber einen Haken. Darin liegt eine der zentralen Herausforderungen für die nächste Entwicklungsphase der KI. Ein Modell, das diese Schritte beschreiben kann, ist noch nicht in der Lage, die motorischen Befehle zu erzeugen, um sie auszuführen. Die physische Welt zu verstehen ist nicht dasselbe wie in ihr zu handeln.
Aus diesem Grund rücken Weltmodelle zunehmend ins Zentrum der KI-Debatte. Weltmodelle sind Systeme, die Maschinen dabei helfen sollen, sich ein internes Bild davon zu machen, wie die physische Realität funktioniert – wie sich Objekte bewegen, wie sich der Raum verändert und wie Handlungen zu wahrscheinlichen Folgeereignissen führen. Deloittes Studie „Enterprise AI 2026“ deutet darauf hin, dass bereits ein operativer Wandel im Gange ist. Dabei entwickeln sich Weltmodelle zu einer praktischen Grundlage für Simulationen, physische KI und Entscheidungsfindung. Für die Weiterentwicklung hin zu allgemeineren KI-Systemen könnten sie daher eine wichtige Rolle spielen.
In den letzten zehn Jahren wurde KI hauptsächlich anhand von Texten und Bildern trainiert. Das hat zu beachtlichen Ergebnissen geführt, doch Sprache ist nach wie vor nur ein schlechter Ersatz für gelebte Erfahrung. Worte können zwar Schwerkraft, Reibung und Gleichgewicht beschreiben, vermitteln jedoch kein direktes Gefühl für Gewicht, Kraft oder Timing.
Physische Intelligenz erfordert etwas anderes. Ein Roboter, der sich in einer Küche bewegt, ein Fahrzeug, das den Verkehr interpretiert, oder ein Arm, der ein Bauteil montiert, muss sein Verständnis der Welt als Reaktion auf Bewegung, Berührung und Unsicherheit ständig aktualisieren. Damit dies gelingt, sind schnelle Wahrnehmung und präzise Vorhersagen gleichermaßen erforderlich.
Weltmodelle setzen an dieser Herausforderung an. Sie ermöglichen es einem KI-System, vor dem Handeln abzuleiten, was als Nächstes geschehen könnte, anstatt erst im Nachhinein zu lernen. Damit können sie Wahrnehmung, Planung und Steuerung miteinander verbinden. Deshalb betrachten viele Forscher sie mittlerweile als wichtigen Baustein für die physische KI und als einen möglichen Weg hin zu einer allgemeineren Intelligenz.
Warum Roboter komplexer sind als Chatbots
Ein Teil der Schwierigkeit liegt in den Daten. Sprachmodelle wurden mit Daten aus dem Internet trainiert, das eine nahezu unbegrenzte Menge an Text bietet. Dieser liegt zudem mehr oder weniger im gleichen Format vor. Die Daten, die benötigt werden, um Maschinen körperliche Fähigkeiten beizubringen, sind ganz anders. Ihre Erfassung ist kostspielig, ihr Umfang begrenzt und sie sind äußerst uneinheitlich: Eine Navigationsroute, ein ferngesteuerter Greifvorgang und ein Dashcam-Clip erfassen die physische Welt in völlig unterschiedlichen, miteinander inkompatiblen Formaten – aufgenommen von Maschinen mit völlig unterschiedlichen Körpern.
Die Suche nach Wegen, diese unterschiedlichen Quellen so miteinander in Einklang zu bringen, dass Maschinen tatsächlich daraus lernen können, ist zu einem der relevanten Forschungsprobleme im Bereich der physischen KI geworden. Aktuelle Open-Source-Veröffentlichungen zeigen, wie mögliche Lösungen aussehen können.
Was aus physischer KI wird
Die jüngsten Forschungsergebnisse von Alibaba zeigen einen möglichen Ansatz. Im Februar stellte die DAMO Academy RynnBrain als Open-Source-Projekt zur Verfügung, ein auf Qwen3-VL basierendes Grundmodell für physische KI, das das Umgebungsverständnis, das räumliche Denkvermögen und die Aufgabenplanung verbessert. Durch die Veröffentlichung auf Hugging Face, GitHub und ModelScope machte Alibaba das Modell zudem Forschern und Entwicklern weltweit zugänglich.
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel IT-Medien GmbH, Max-Josef-Metzger-Straße 21, 86157 Augsburg, einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von Newslettern und Werbung nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung.
Im Juni folgte ein weiterer Ansatz, um die Kluft zwischen Sehen und Handeln zu überbrücken: die Qwen-Robot Suite, drei Grundmodelle, die jeweils Sprache in unterschiedliche Formen physischen Handelns übersetzen.
Die Architektur gliedert sich dabei in drei Bereiche. Qwen-RobotNav übernimmt die Mobilität, von gesprochenen Navigationsanweisungen bis hin zum autonomen Fahren. Qwen-RobotManip befasst sich mit der physischen Interaktion anhand einer gemeinsamen Darstellung von Zuständen und Aktionen, die es ermöglicht, Daten von sehr unterschiedlichen Robotern für ein gemeinsames Training zu nutzen. Dadurch wurden mehr als 38.100 Stunden zuvor fragmentierter Open-Source-Trainingsdaten nutzbar gemacht.
Das dritte Modell, Qwen-RobotWorld, ist ein Weltmodell. Es sagt voraus, wie die physische Umgebung im nächsten Moment aussehen könnte. Dadurch kann ein Roboter die möglichen Folgen einer Handlung simulieren, bevor er sie ausführt, anstatt erst durch Versuch und Irrtum herauszufinden, was passiert.
Relevant ist dieser Ansatz auch deshalb, weil Erfahrungen aus einem Bereich dazu beitragen können, die Fähigkeiten in einem anderen zu verbessern. Durch Manipulation verbessert sich das Verständnis eines Modells für die Kontaktphysik, das Autofahren trägt zum Verständnis großräumiger Geometrie bei, während die Navigation ein umfassenderes räumliches Denkvermögen fördert. Anstatt für jede Aufgabe separate Systeme zu trainieren, lässt sich so schrittweise ein gemeinsames Verständnis davon entwickeln, wie die physikalische Welt funktioniert.
Interessant wird das Zusammenspiel dieser Komponenten, wenn sie gemeinsam eingesetzt werden. Da jedes Modell Anweisungen in einfacher Sprache versteht, kann eine universell einsetzbare KI sie ähnlich wie jedes andere Werkzeug koordinieren. Ein Modell plant, ein anderes navigiert, ein weiteres führt Manipulationen durch, sodass übergeordnetes Denken in physische Handlungen umgesetzt werden kann.
In einer Demonstration nimmt ein übergeordnetes Modell die Anweisung „Räume den Tisch auf“ entgegen, zerlegt sie in einfache Schritte, übergibt jeden einzelnen Schritt an das Manipulationsmodell, überwacht den Fortschritt und plant neu, wenn etwas ins Stocken gerät.
In einem anderen Fall entdeckt ein Agent, der beauftragt wurde, in einem ihm unbekannten Gebäude eine freie Toilette zu finden, an der ersten Toilette, die er erreicht, ein Schild mit der Aufschrift „Reinigung im Gange“ und wechselt daraufhin die Richtung, um die andere Seite des Gebäudes zu durchsuchen. Solche Beispiele zeigen, wie abstrakte Planung mit konkretem Handeln in der physischen Welt verbunden werden kann.
Der größere Gewinn
Die nächste Entwicklungsphase der KI könnte daher stärker von Systemen geprägt sein, die die physische Welt nicht nur beschreiben, sondern auch modellieren, Vorhersagen treffen und auf dieser Grundlage handeln können.
Xiong-Hui Chen
(Bild: Alibaba Cloud)
So wie Sprachmodelle der KI das Sprechen beigebracht haben, könnten Weltmodelle ihr beibringen, die Realität zu verstehen. Und wenn sich dieses Verständnis auf verschiedene Roboter, Umgebungen und Aufgaben übertragen lässt, könnte sich die Branche auf etwas noch Größeres zubewegen: eine allgemeine Intelligenz, die nicht auf Text beschränkt ist, sondern in der physischen Welt verankert ist.
Über den Autor
Xiong-Hui Chen, Research Scientist bei Alibaba Cloud.