Ein Prototyp des Fraunhofer SIT soll in laufenden Videocalls gefälschte Gesichter und Stimmen erkennen. Auf Benchmark-Datensätzen erreicht er einen F1-Score von 0,93. Für echte Konferenzbedingungen ist er noch nicht getestet, und bei unbekannten Fälschungsverfahren bricht die Erkennung ein.
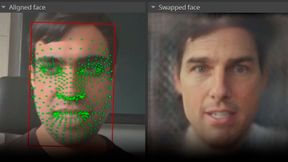
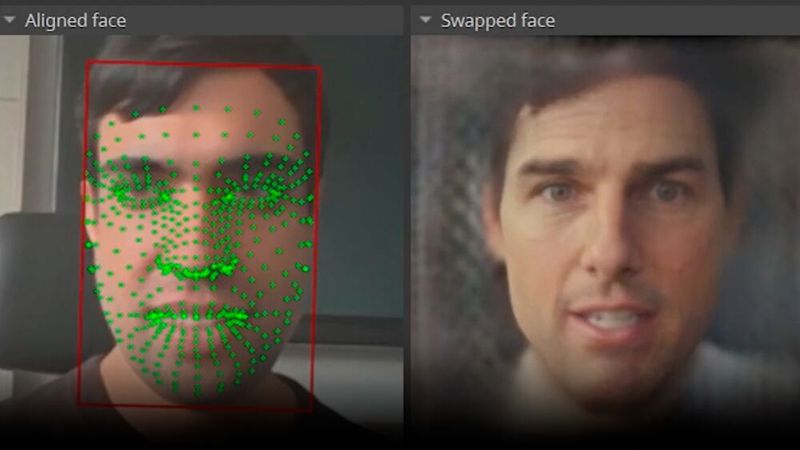
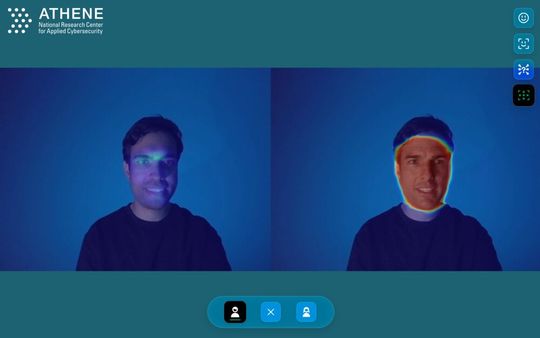
Der Detektor des Fraunhofer SIT bewertet jedes Gesicht im Videocall mit einem Score. Eine Heatmap zeigt, welche Bildbereiche die Entscheidung beeinflusst haben.
(Bild: Fraunhofer SIT)
Forscher des Fraunhofer-Instituts für Sichere Informationstechnologie (SIT) haben einen Deepfake-Detektor für Live-Videokonferenzen entwickelt. Der Prototyp ist ein funktionsfähiger Forschungsaufbau, aber noch kein marktreifes Produkt. Für jedes Gesicht im Bild berechnet das System, wie wahrscheinlich es per Face Swapping ausgetauscht oder KI-generiert ist. Die Stimme prüft es ebenfalls. Vorgestellt wurde der Detektor auf der it-sa in Nürnberg am Stand des Forschungszentrums ATHENE.
Das Einsatzszenario ist CEO-Fraud per Videocall. Angreifer geben sich mit einem Deepfake als Vorgesetzte aus und veranlassen Mitarbeiter zu Überweisungen. Der Ingenieurkonzern Arup verlor so rund 25 Millionen US-Dollar.
Wie verbreitet solche Angriffe inzwischen sind, zeigt die Wirtschaftsschutzstudie des Bitkom: Acht Prozent der deutschen Unternehmen ist im vergangenen Jahr ein Schaden durch Deepfakes entstanden, doppelt so viele wie im Vorjahr. Bei automatisierten Robo-Calls stieg der Anteil laut der Befragung von 1.003 Unternehmen von drei auf 14 Prozent.
Mit bloßem Auge sind solche Fälschungen kaum zu erkennen. Laut einer Erhebung von BSI und Polizei trauen sich das zwar 47 Prozent der Internetnutzer in Deutschland zu, 32 Prozent haben aber noch nie eine gängige Prüfmethode angewendet.
Das primäre Modell ist ein Klassifikator, trainiert mit echten und manipulierten Videodaten. Er analysiert jedes erkannte Gesicht einzeln und gibt einen Wahrscheinlichkeitswert aus. In einem zweiten Modus markiert eine farbige Heatmap per Grad-CAM (Gradient-weighted Class Activation Mapping) die Bildbereiche, die das Urteil am stärksten beeinflusst haben.
Die Markierung folgt der Kontur des eingesetzten Gesichts bis zum Haaransatz und zum Kinn. Im echten Bild bleibt sie weitgehend aus.
(Bild: Fraunhofer SIT)
Das zweite Modell, ein Segmentierungsmodell, sei noch in Entwicklung. Es analysiere lokale Unterschiede im Bildrauschen: Wo ein Gesichtsbereich ausgetauscht wurde, verhalte sich das Rauschen anders als im übrigen Bild, so das Fraunhofer SIT. Weil das Modell keine Artefakte bestimmter Fälschungswerkzeuge sucht, soll es auch Verfahren erkennen, die es nie gesehen hat. Dasselbe Ziel verfolgen die FAU Erlangen-Nürnberg und Secunet bei manipulierten Bildern, allerdings mit vortrainierten neuronalen Netzen.
Benchmark-Werte gelten nicht für Live-Calls
Auf vier Benchmark-Datensätzen erreicht das Gesichtsmodell nach Angaben des Instituts einen gemittelten F1-Score von 0,93. Der Wert fasst Trefferquote und Präzision zusammen, 1,0 wäre fehlerfrei. Die Audio-Erkennung kommt auf Testsets auf 0,9.
Diese Zahlen seien nicht repräsentativ für Live-Deepfakes, räumt das Institut selbst ein, da Videos in der Praxis andere Eigenschaften hätten. Wie stark Kompression, schwankende Bandbreite, Gesichtsfilter oder schlechtes Licht die Genauigkeit senken, hat das Team noch nicht untersucht.
Das größere Problem sei die Generalisierung. Bei Fälschungsverfahren, die nicht im Training vorkamen, breche die Erkennungsrate ein. Zwei SIT-Wissenschaftler hatten das bereits in einem Gastbeitrag zur Deepfake-Forensik beschrieben: Klassische Verfahren seien jeweils nur für eine bestimmte Angriffsart empfindlich, KI-Detektoren müssten laufend nachtrainiert werden. Teilweise gleicht der neue Detektor das mit einer Mehrheitsentscheidung über mehrere Frames aus. Da sich die Personen in einem Videocall kaum ändern, lasse sich das Urteil über die Zeit absichern. Das helfe vor allem, wenn ein Gesicht nicht frontal zur Kamera zeigt.
Das Gesichtsmodell analysiert alle 1,25 Sekunden einen Frame. Mit jedem weiteren Gesicht im Bild steigt die Latenz. Das Segmentierungsmodell braucht länger, bleibt aber laut Institut unter drei Sekunden. Für einen Betrugsversuch im Gespräch sei das schnell genug.
Die Analyse läuft vollständig auf einem leistungsstarken Gaming-Laptop, Videodaten gehen nicht an externe Server. Das erleichtert den Einsatz mit Blick auf Datenschutz und Betriebsrat. Den Videostrom greift der Detektor derzeit direkt ab oder liest das Bild vom Bildschirm aus. In einer fertigen Anwendung soll er direkt im Konferenzwerkzeug laufen.
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel IT-Medien GmbH, Max-Josef-Metzger-Straße 21, 86157 Augsburg, einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von Newslettern und Werbung nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung.
Für die Stimme gibt es auch andere Ansätze. Das Projekt PADSE, an dem das Fraunhofer IDMT beteiligt ist, gleicht Audios mit Stimmprofilen realer Personen ab, statt nach generischen Merkmalen synthetischer Stimmen zu suchen. Die ETH Zürich setzt ganz auf Herkunft: Ihr Sensorchip signiert Aufnahmen schon im Gerät, damit sich die Echtheit nachweisen lässt, ohne Fälschungen erkennen zu müssen.
Partner gesucht
Ein Produkt gibt es noch nicht. Das Fraunhofer SIT will die Technik lizenzieren und sucht Partner für die prototypische Weiterentwicklung. Wann der Detektor marktreif sein könnte, hänge von der Resonanz der Anwender ab. Integrieren lasse sich der Detektor nur gemeinsam mit Anbietern von Videokonferenzlösungen, und dafür müsse man zuerst klären, mit welcher Bildqualität zu rechnen ist und wie die Einbindung ins Produktivsystem aussieht. Entwickelt wurde er am Fraunhofer Heilbronn Forschungs- und Innovationszentrum (HNFIZ).