Voice Agents fallen Anrufern ins Wort, schweigen während einer Abfrage oder überhören Korrekturen. Deepgram will das mit zwei spezialisierten Sprachmodellen und einem offenen Kontextstandard ändern. Den Unterbau soll das Open-Source-Framework Pipecat liefern, dessen Hersteller Daily Deepgram übernehmen will.
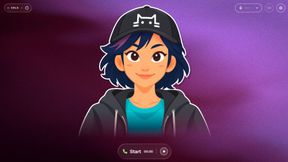
Eine Demo zeigt, wie ein Voice Agent auf Basis von Pipecat und RCS reagiert, wenn Anrufer flüstern, zögern oder sich korrigieren.
(Bild: speak26.pipecat.ai)
Auf seiner ersten Hausmesse Deepgram Speak in San Francisco hat der Speech-AI-Anbieter Deepgram zwei Large Language Models vorgestellt, die speziell für Sprachagenten entwickelt wurden. Den Hintergrund beschreibt Deepgram-CPO Ed Anuff: Das LLM eines Voice Agents habe zwei Aufgaben, die in unterschiedliche Richtungen zögen. Es müsse in Sekundenbruchteilen erkennen, ob ein Anrufer ausgeredet hat oder nur nachdenkt. Gleichzeitig solle es Geschäftsregeln befolgen, Tools aufrufen und passende Antworten formulieren. Ein einzelnes Allzweckmodell erledige nach Anuffs Erfahrung keine der beiden Aufgaben besonders gut.
Ein Modell fürs Gespräch, eines für die Arbeit
Das „Think-Live LLM“ übernimmt laut Deepgram die Gesprächsführung. Es entscheidet, wann der Agent zuhört, abwartet oder antwortet. So soll es verhindern, dass der Agent Anrufern ins Wort fällt oder Gesprächspausen entstehen. Das Modell ist allgemein verfügbar und lässt sich über die Deepgram Voice Agent API nutzen. Das „Think-Fast LLM“ arbeitet im Hintergrund. Es befolgt Anweisungen, ruft während des Gesprächs externe Tools auf und formuliert Antworten, die für die Sprachausgabe optimiert sind. Dieses Modell steht vorerst nur im Early Access über die Deepgram-LLM-API bereit. Entwickler können beide Modelle kombinieren oder jeweils mit einem bereits genutzten Modell koppeln. Angaben zu Latenz, Modellgröße oder Preisen macht Deepgram bislang nicht.
Anuff nennt ein Beispiel: Ein Kunde will eine Lieferung verschieben und korrigiert sich, während der Agent noch nach freien Terminen sucht. Statt Freitag passe ihm nun Donnerstag. Think-Live bestätige die Änderung sofort, während Think-Fast die Anfrage anpasse und die Suche abschließe.
Der zweite Baustein ist der Real-Time Context Standard (RCS). Die meisten Voice Agents verketten heute Speech-to-Text, ein LLM und Text-to-Speech. An jeder Schnittstelle gehen dabei Informationen wie Tonfall, Flüstern oder Zögern verloren, weil nur der reine Text weitergereicht wird. RCS ergänzt das verbreitete Chat-Completions-Format deshalb um drei Felder. Das erste beschreibt, wie der Sprecher klang. Das zweite legt fest, wie der Agent darauf reagieren soll. Das dritte gibt dem Text-to-Speech-Modell vor, wie die Antwort gesprochen werden soll. Deepgram vergleicht den Ansatz mit Tool Calling und dem Model Context Protocol (MCP).
Das Unternehmen bezeichnet RCS als herstellerunabhängigen, offenen Standard, den es gemeinsam mit dem Pipecat-Team entwickelt hat. Die Spezifikation samt Demo liegt auf GitHub und ist zur Kommentierung offen. Weitere Unterstützer außerhalb von Deepgram und Pipecat werden bislang nicht genannt.
Damit ist der Standard eng an Deepgrams eigene Strategie geknüpft. Das Unternehmen hat angekündigt, Daily zu übernehmen, den Hersteller von Pipecat. Einen Kaufpreis haben die Unternehmen nicht genannt. Pipecat soll nach Angaben von Deepgram unter der bisherigen BSD-Lizenz Open Source bleiben und weiterhin Modelle anderer Anbieter unterstützen. Zudem wollen beide Firmen eine unabhängige Pipecat Foundation gründen.
Auf Pipecat baut Deepgram eine Voice-Agent-Plattform, die das Framework, RCS und die eigenen Modelle zusammenführen soll. Entwickler sollen ihre Agents dort über Deepgram oder in der eigenen Cloud betreiben können. Einen Zeitplan gibt es laut Unternehmen noch nicht.
Deutsch bei der Sprachausgabe verfügbar
Erweitert hat Deepgram auch die Sprachunterstützung. Das Sprachausgabemodell Flux TTS ist in neun Sprachen allgemein verfügbar, darunter Deutsch, Französisch und Italienisch. 32 weitere Sprachen befinden sich im Early Access. Bei der Spracherkennung für Voice Agents unterstützt Flux STT Multilingual zehn Sprachen allgemein, 31 weitere im Early Access. Das Transkriptionsmodell Nova-3 Multilingual deckt 55 Sprachen ab. Für die Datenverarbeitung bietet Deepgram regionale Endpunkte in den USA, der EU, Indien und Australien an, über die Verarbeitung und Speicherung in der jeweiligen Region bleiben. Eine Global API für Verbindungen mit geringerer Latenz ist angekündigt.
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel IT-Medien GmbH, Max-Josef-Metzger-Straße 21, 86157 Augsburg, einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von Newslettern und Werbung nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung.