Hadoop, das fast schon synonym für Big Data genannte Framework zum Verarbeiten großer Datenmangen, feiert in diesem Jahr seinen zehnten Geburtstag. BigData-Insider blickt gemeinsam mit dem Hadoop-Erfinder Doug Cutting auf die vergangenen zehn Jahre zurück und befragt ihn nach seiner Einschätzung zur Zukunft von Big Data und Hadoop.
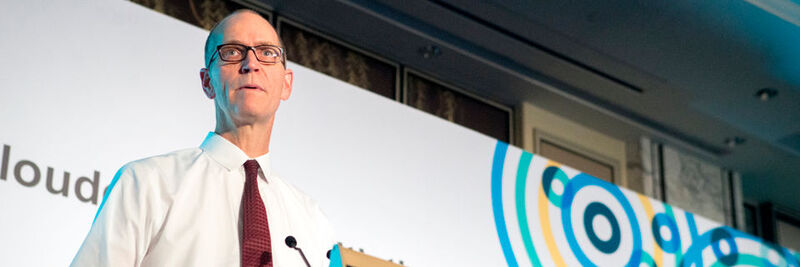
Douglas „Doug“ Cutting
(Bild: Cloudera)
Hadoop und das verteilte HDFS-Dateisystem sind trotz vieler Fortschritte im Bereich Echtzeit- und Streaming-Verarbeitung das bei den weitaus meisten großen Unternehmen eingesetzte Big-Data-Framework für das schnelle Analysieren unstrukturierter Daten. Dass sich letztlich das von Douglas „Doug“ Cutting entwickelte Framework als Quasi-Standard etablieren sollte, war dabei anfangs gar nicht absehbar. Wie genau die Umstände der Entstehung von Hadoop waren, kann niemand besser erläutern als der inzwischen bei Cloudera beschäftigte Erfinder selbst.
BigData-Insider: Herr Cutting, Gratulation! Hadoop ist jetzt zehn Jahre alt. Wie kam es zur Entwicklung des Frameworks? Sie hatten ja bereits mit Lucene Erfahrungen gesammelt und Anleihen zu MapReduce stammen von Google, oder?
Cutting: Wir arbeiteten seinerzeit an einem Problem, bei dem skalierbare, verteilte Datenberechnungen benötigt wurden. Die Software bestand aus einem Open-Source-Projekt, Apache Nutch. Zu dieser Zeit veröffentlichte Google Beschreibungen von verteilten Computing-Methoden, die den in Nutch eingesetzten Lösungen weit überlegen waren. Daher implementierten wir diese Methoden als Open Source innerhalb von Nutch. Als die Leute erkannten, dass dies auch über Nutch hinaus nützlich sein würde, bildeten wir ein neues Projekt und nannten es Hadoop. Das war der Name, den sich mein Sohn für seinen Stoffelefanten ausgedacht hatte. Inspiriert hatten uns aber letztendlich die technischen Veröffentlichungen von Google.
Es steht heute außer Frage, dass Hadoop sich als Basis-Framework für skalierbare, verteilt arbeitende Software zum Quasistandard entwickelt hat. Im Rahmen der medialen Berichterstattung ist Hadoop gleichbedeutend mit Big Data und Analytics. Dabei muss man zwischen dem von Ihnen initiierten Framework, dem HDFS-Dateisystem und dem eigentlichen Map-Reduce-Algorithmus auf der einen Seite sowie darauf aufbauenden Technologien und Lösungen auf der anderen Seite unterscheiden. Glauben Sie, dass Lösungen aus dem Apache-Ökosystem in Zukunft die eigentlichen Basis-Technologien, namentlich Hadoop, zumindest in der öffentlichen Wahrnehmung verdrängen?
Cutting: Richtig, Apache Hadoop umfasst zwei Teile. Zunächst gibt es das Hadoop-Projekt, das HDFS und MapReduce beinhaltet. Es gibt aber auch das Ökosystem anderer Apache-Projekte, die sich um Hadoop gebildet haben. Der erstgenannte Teil kann im Laufe der Zeit tatsächlich an Bedeutung verlieren. Der andere Teil aber wird weiter wachsen und scheint sogar die Oberhand zu gewinnen. Das Hadoop-Projekt wird in den künftigen Datensystemen der Menschen nicht immer eine zentrale Rolle spielen, das Hadoop-Ökosystem aber ganz bestimmt, weil sein Evolutionsmodell am nachhaltigsten ist.
Wie wird Ihrer Einschätzung nach das Thema Big Data in der Öffentlichkeit wahrgenommen?
Cutting: Big Data kommt in der Öffentlichkeit nicht immer gut an. Meiner Meinung nach verstehen die Menschen zwar, dass Big Data für viele der guten Dinge verantwortlich ist, die wir jeden Tag erleben, wie zum Beispiel die Spracherkennung, bequeme Telekommunikation, komfortables Shopping, verbesserte Gesundheitsfürsorge und so weiter. Die Menschen sind aber auch zu Recht besorgt, dass Big Data ihre Privatsphäre einschränken könnte. Sicherzustellen, dass Daten nicht missbraucht werden, ist jedoch keine rein technische, sondern vor allem eine gesellschaftliche Frage. Ich bin optimistisch, dass wir wirksame Schutzmaßnahmen entwickeln können, sodass Menschen den Institutionen, die Daten erheben, vertrauen können.
Welche Vorstellungen haben Ihrer Meinung nach Unternehmen, Institutionen und Verbraucher vom Wert von Big Data Analytics? Der Bogen reicht ja von Social Marketing bis zu Smart Citys.
Cutting: Die Unternehmen haben bemerkt, dass sie ihre Geschäfte am effektivsten durch die Nutzung von Daten verbessern können. Fast jede Institution besitzt Schnittstellen zur digitalen Welt und erzeugt darüber hinaus auch relevante Daten. Um Wettbewerbsvorteile zu erzielen, muss der Nutzen dieser Daten analysiert werden. Das Hadoop-Ökosystem bietet dafür das beste Werkzeug. Das gilt für nahezu jede Branche: Banken, Versicherungen, Gesundheitswesen, Fertigung, Einzelhandel, Telekommunikation, Regierungsbehörden usw. Allerdings beschleunigt das Internet of Things diese Entwicklung und führt zur Digitalisierung weiterer Branchen.
Hortonworks – treibende Kraft hinter den Apache-Projekten rund um Hadoop – hat angekündigt, seine Hadoop-Unternehmensversion HDP ab jetzt häufiger zu aktualisieren. Zudem kooperiert Hortonworks offenbar jetzt mit Hewlett-Packard Enterprise (HPE), was aber in erster Linie zu weiteren Verbesserungen von Apache Spark führen soll. Auf anderen Seite sollen Kernkomponenten von Apache Hadoop wie das Dateisystem HDFS, der Algorithmus MapReduce, das Cluster-Management-System YARN sowie das Konfigurationssystem Zookeeper nur jährlich aktualisiert werden, auf Hadoop aufsetzende Dienste wie Spark, Hive, HBase und Ambari on Block dagegen mehrmals jährlich. Wie beurteilen Sie dieser Entwicklung und welche Strategie verfolgt Cloudera?
Cutting: Es geht letztendlich immer um einen Kompromiss zwischen Agilität und Stabilität. Unabhängig voneinander freigegebene Dinge verschaffen den Nutzern häufig mehr Flexibilität. Für einen zuverlässigen Betrieb erfordert der Zugang zu neueren Features aber auch eine komplexere Umgebung. Wenn vier unterschiedliche Versionen aus vier Komponenten beliebig miteinander vermischt werden können, dann benötigen 256 unterschiedliche Kombinationen Support. Versionen bereitzustellen, die mit einem Upgrade-Pfad zusammenarbeiten, stellt eine der wichtigsten Aufgaben eines Anbieters dar. Wir erleben oft, dass diejenigen, die ohne einen Lieferanten arbeiten, an einen bestimmten Satz gepatchter Versionen gebunden sind und keine Möglichkeit zum Upgrade haben. Ein Anbieter, der weniger Optionen bereitstellt, mag folglich vielleicht erst einmal kurzfristig für Frustration sorgen, aber auf lange Sicht könnte die Stabilität seines Systems von Nutzen sein. Für Abenteurer bietet Cloudera übrigens über Cloudera Labs einen frühzeitigen Zugriff auf noch nicht unterstützte Software.
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel IT-Medien GmbH, Max-Josef-Metzger-Straße 21, 86157 Augsburg, einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von Newslettern und Werbung nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung.